
Veröffentlicht am 13. Oktober 2026 | Luka Eble
Als wir für einen Kunden die erste Wissensbasis aufgebaut haben, lagen allein zur Positionierung und Markenidentität sechs Dokumente im Ordner. Vier trugen ein Datum im Dateinamen: 17., 18., 19. und 21. Dezember. In den Dateinamen standen zwei verschiedene Verfasser, und eine Datei hieß „ULTIMATE“. Daneben lagen vier Fassungen der Broschüre.
Jede dieser Dateien war an ihrem Tag richtig. Hochgeladen wären sie schnell gewesen, und eine KI hätte alle sechs gleich ernst genommen.
Bei den Broschüren war die Sache einfach, es blieb die neueste. Die sechs Dokumente kamen alle in die Wissensbasis. Für die beiden Fassungen der Markenidentität haben wir uns mit einer Rangfolge geholfen: Die Datei mit „ULTIMATE“ im Namen führt, die ältere füllt Lücken. Das war eine Regel für die Maschine. Welche Positionierung in dieser Firma gilt, hatte damit noch niemand entschieden.
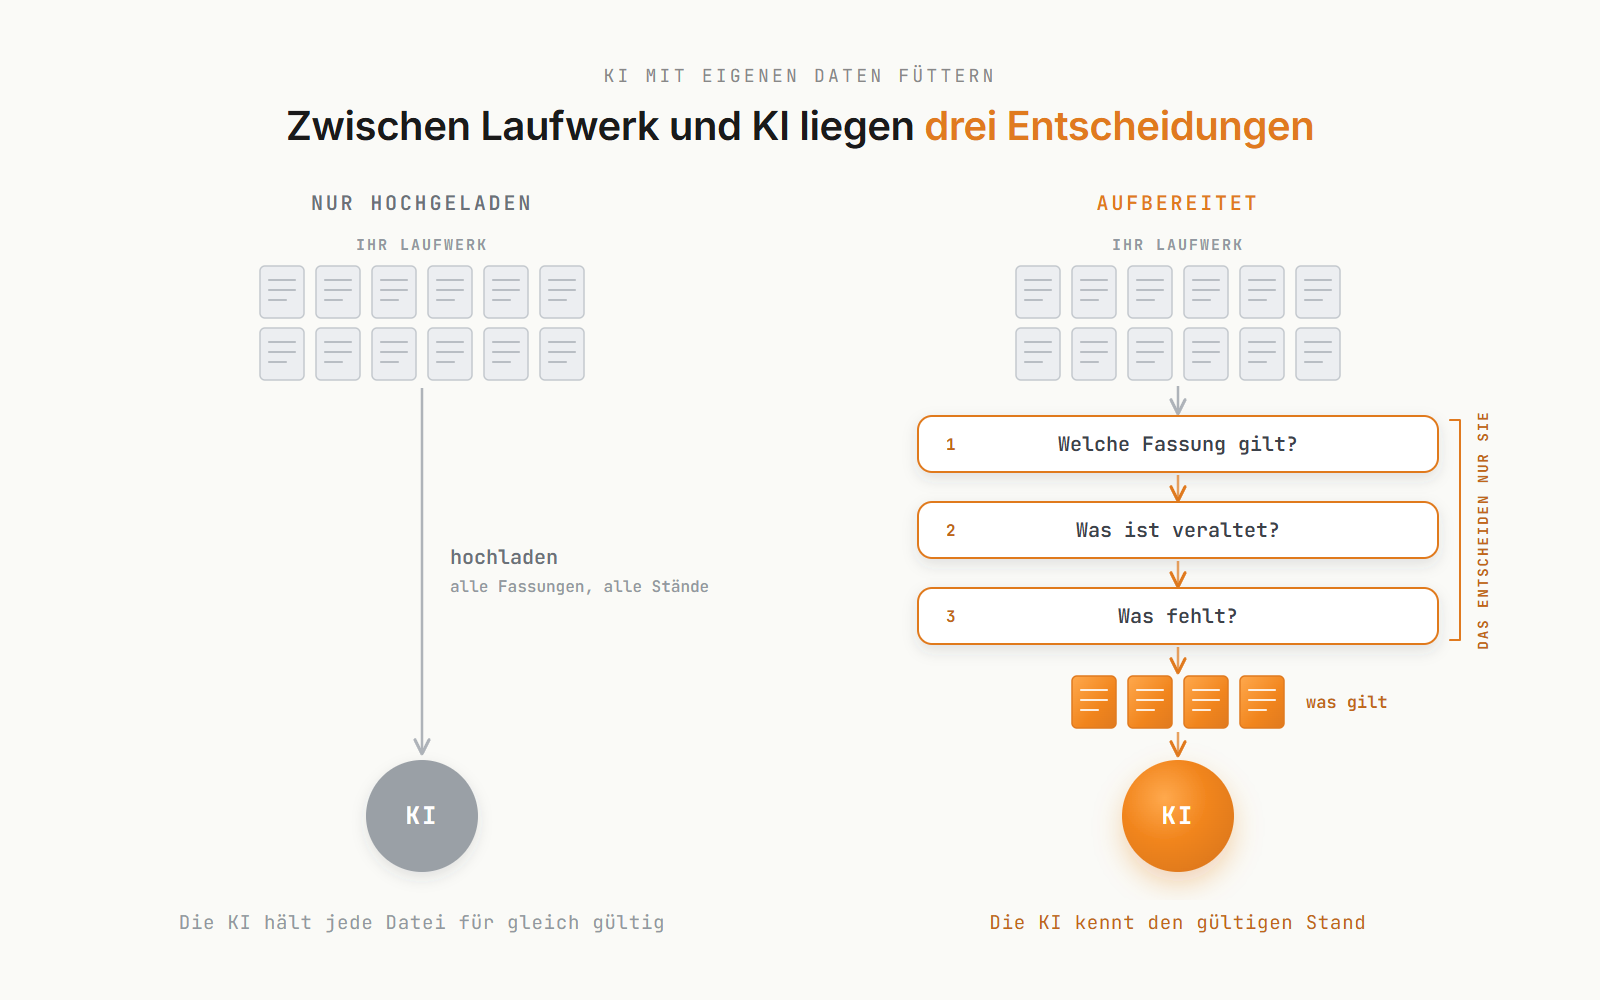
Seitdem sehen wir das Hochladen anders. Wer seine Unterlagen in eine KI lädt, gibt ihr Material. Was davon gilt, erfährt sie dadurch nicht. Diese Auskunft zu geben, ist die eigentliche Arbeit, und sie kostet vor allem die Zeit des Inhabers.
Was heißt es, eine KI mit eigenen Daten zu füttern?
In fast allen Fällen heißt es, dass die KI bei jeder Frage in Ihren Unterlagen nachschlägt. Trainiert wird dabei nichts.
Es gibt drei Wege. Sie legen eine Datei in den Chat, dann kennt die KI sie für dieses eine Gespräch. Sie richten einen Assistenten mit einer festen Wissensgrundlage ein, dann sucht er zu jeder Frage die passenden Textstücke heraus und formuliert daraus die Antwort. Oder Sie lassen ein Modell mit Ihren Daten nachtrainieren. An den dritten Weg denken viele, wenn sie „füttern“ oder „trainieren“ sagen. Für eine Firma mit zwölf Leuten ist er fast nie nötig, denn Preise, Leistungen und Ansprechpartner ändern sich. In einer Wissensgrundlage tauschen Sie dann eine Datei aus. Ein nachtrainiertes Modell müssten Sie erneut trainieren.
Ob Sie Unterlagen mit personenbezogenen Daten überhaupt hochladen dürfen, ist eine eigene Frage. Sie gehört vor den ersten Upload und ist nicht Thema dieses Beitrags.
Warum ändert sich nach dem Hochladen so wenig?
Weil die KI jede Datei für gleich gültig hält. Die Fassung vom 17. Dezember zählt für sie so viel wie die vom 21. Sie sieht Text und kein Verfallsdatum.
Nehmen wir ein Büro mit zwölf Leuten, das seit dem Frühjahr eine KI-Lizenz für das Team bezahlt und den Ordner „Vertrieb“ hochgeladen hat. Darin liegen das Preisblatt vom letzten Jahr und das aktuelle. Auf die Frage nach dem Tagessatz antwortet die KI am Montag mit der einen Zahl und am Donnerstag mit der anderen. Beide Antworten sind belegt. Nach zwei Wochen fragt das Team wieder den Chef.
Das Büro ist ein Beispiel. Dass die Lizenz allein wenig ändert, sagt auch der Digitalverband Bitkom. Er hat im Sommer 2026 603 Unternehmen befragt. 57 Prozent setzen KI ein, ein Jahr zuvor waren es 36 Prozent. Kein Unternehmen, das KI im Einsatz hat, gibt an, deren Potenzial vollständig zu nutzen. Bitkom-Präsident Ralf Wintergerst sagt in derselben Mitteilung: „Wer nur eine Lizenz kauft, hat KI eingekauft, aber noch nichts verändert.“
Befragt wurden Unternehmen ab 20 Beschäftigten. Firmen mit zehn oder fünfzehn Leuten kommen in diesen Zahlen nicht vor. Wir sehen keinen Grund, warum es dort anders sein sollte, belegen können wir es mit dieser Quelle nicht. Warum das Wissen einer Firma inzwischen mehr ausmacht als das Modell, steht im Beitrag Wenn KI zur Ware wird.
Was heißt Daten aufbereiten?
Aufbereiten heißt, zu jeder Unterlage drei Fragen zu beantworten, bevor sie in die Wissensgrundlage kommt.
- Welche Fassung gilt?
- Was ist veraltet?
- Was fehlt?
Mit Dateiformaten hat das wenig zu tun. Ob ein Dokument als PDF oder als Word-Datei vorliegt, lösen Werkzeuge. Die drei Fragen löst kein Werkzeug, weil die Antwort in keiner Datei steht.
Am Ordner unseres Kunden hat uns eines überrascht: Die Widersprüche waren nicht alt. Vier Fassungen trugen Daten aus fünf Tagen. In dieser Woche wurde an der Positionierung gearbeitet. Die einzige Auskunft darüber, welche Fassung am Ende gewonnen hatte, war ein Wort in einem Dateinamen. Wir vermuten, dass es in den meisten kleinen Firmen so entsteht. Das Durcheinander kommt aus den Wochen, in denen viel geschafft wurde.
Die dritte Frage ist die unauffälligste. In Unterlagen steht, was jemand aufgeschrieben hat. Welchen Auftrag Sie ablehnen würden und welchem Kunden Sie einmal eine Ausnahme zugesagt haben, steht oft nirgends.
Alle drei Fragen betreffen die Positionierung genauso wie das Preisblatt, die Leistungsbeschreibung, die Präsentationsvorlage und den Farbwert des Logos. Ihre Marke besteht aus all dem zusammen: Strategie, Werte, Auftreten, Vokabular und Gestaltung. Wie das in geordneter Form aussieht, zeigt die Seite zum Markencharakter für KI.
Warum beantwortet die KI ein vollständiges Dokument unvollständig?
Weil sie bei einer Frage nicht den ganzen Bestand liest. Ein Assistent mit Wissensgrundlage bekommt einige Textstücke vorgelegt, die zur Frage passen, und antwortet aus diesen. Das Verfahren heißt Retrieval-Augmented Generation.
Im Sommer fragten wir den Assistenten desselben Kunden nach allen Fachleuten, mit denen die Firma arbeitet. Er nannte sechs. In der Liste, die hochgeladen war, standen 25. An anderer Stelle im Bestand war von „rund 35″ die Rede.
Erfunden hatte der Assistent nichts. Die Liste lag vollständig vor, sie war aber beim Einlesen in mehrere Stücke zerschnitten worden, und bei der Frage kam nur eines davon an. Das war eine von mehreren Ursachen, und sie ließ sich technisch beheben: Die Liste wird seitdem als ein Stück eingelesen. Ob 25 oder 35 stimmt, ließ sich so nicht beheben. Das wusste nur der Inhaber.
Vollständig im Ordner heißt also noch lange nicht vollständig in der Antwort. Sie können das an Ihrer eigenen KI prüfen. Fragen Sie nach einer Liste, die Sie auswendig kennen, etwa nach allen Leistungen oder allen Ansprechpartnern, und zählen Sie nach.
Wer muss diese Arbeit machen?
Der Inhaber, aber nicht allein. Sichten, sortieren, Dubletten finden und alles in eine einheitliche Form bringen, das kann eine Mitarbeiterin übernehmen, ein Dienstleister oder zum Teil die KI selbst. Die Antwort auf „Gilt das noch?“ kann niemand davon geben.
Wir haben das an uns selbst gemerkt. Wir hätten den Ordner unseres Kunden weitersortieren können, bis alles ordentlich aussah. Die Rangfolge vom Anfang war genau das: eine ordentliche Lösung für eine Frage, die uns nicht zustand. Ein Außenstehender kann eine Regel bauen. Entscheiden kann nur, wer die Firma verantwortet.
Gute Vorarbeit macht aus einem unübersichtlichen Ordner deshalb eine überschaubare Liste von Fragen an den Inhaber. Der Aufwand ist kleiner, als er beim ersten Blick auf das Laufwerk aussieht. Abgeben lässt er sich trotzdem nicht.
Was kostet es, die eigenen Daten aufzubereiten?
Vor allem Zeit des Inhabers, und den größten Teil davon am Anfang. In der Bitkom-Befragung nennen 51 Prozent der KI-Anwender die Infrastruktur als großen Kostenpunkt, also Cloud und Rechenleistung. Direkt dahinter liegt mit 50 Prozent die Aufbereitung von Daten. Abos und Lizenzen nennen 21 Prozent, den Token-Verbrauch 8 Prozent. Die Lizenz, die als Erstes auf der Rechnung steht, liegt weit hinten.
Ein Unternehmen mit 200 Beschäftigten hat für die Datenaufbereitung womöglich eine Stelle oder ein Budget. In einer Firma mit zwölf Leuten steht dieser Posten auf keiner Rechnung. Er steht im Kalender des Inhabers, und dort konkurriert er mit Kundenterminen.
Dass sich der Aufwand lohnen kann, legt eine Meldung von KfW Research vom September 2026 nahe. Mittelständische Unternehmen, die KI nutzen, weisen demnach ein stärkeres Umsatzwachstum, eine höhere Rendite und eine höhere Produktivität auf, auch wenn der Einfluss zentraler anderer Erfolgsfaktoren herausgerechnet wird. Die Meldung spricht von einem Zusammenhang zwischen KI-Nutzung und Unternehmenserfolg. Die Studie dahinter haben wir nicht ausgewertet.
Was haben Sie nach der Aufbereitung?
Einen Assistenten, der den gültigen Stand kennt und dazusagt, aus welchem Dokument er ihn hat. Ihr Team fragt ihn nach der aktuellen Leistungsbeschreibung und klopft dafür nicht mehr bei Ihnen an. Angebot, Präsentation und Mail entstehen aus derselben Grundlage, im Ton und im Auftritt Ihres Hauses, ohne dass jemand der KI die Firma neu erklärt. Und Sie lesen nicht mehr jede Zahl gegen. Das beschreiben wir als KI-Markengehirn.
Qualität des KI-Outputs = Wahl des KI-Modells × alle Informationen über Ihre Marke
Das Modell ist für alle gleich. Den Unterschied macht, ob und wie Ihre Daten KI-lesbar hinterlegt sind.
Das „wie“ in dieser Formel ist die Aufbereitung. Welche Ebenen ein Dokument braucht, damit die KI darin nichts erfinden muss, zeigt der Beitrag über Angebote, Verträge und Präsentationen mit KI.
Bevor Sie etwas hochladen oder neu sortieren, reicht ein Test von zehn Minuten. Öffnen Sie den Ordner, den Ihre KI kennt oder kennen soll, und stellen Sie sich eine neue Mitarbeiterin an ihrem ersten Tag vor.
Welche Dateien aus diesem Ordner würden Sie ihr ausdrücklich nicht geben?
Diese Dateien liest Ihre KI gerade mit.
Welche Fragen zu Ihren Unterlagen können nur Sie beantworten? Im kostenlosen KI-Marken-Check ordnen wir das gemeinsam ein.
Quellen: Bitkom, Presseinformation „Erstmals nutzt die Mehrheit der Unternehmen KI“ vom 14. September 2026, 603 Unternehmen ab 20 Beschäftigten (bitkom.org). KfW Research, Meldung „Mittelständische KI-Nutzer sind erfolgreicher“ vom 15. September 2026 (kfw.de). Zum Verfahren: Lewis et al., „Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks“, NeurIPS 2020 (arxiv.org/abs/2005.11401). Die Beobachtungen aus dem Kundenprojekt stammen aus unseren Arbeitsnotizen von Mai und Juli 2026.
Lesen Sie auch
Wenn jeder seine eigene KI nutzt, wird die Marke zur Zufallssache
Warum freie Tool-Wahl und ein vorgeschriebenes Tool zum selben Problem führen.
Markenhandbuch für Maschinen: Wie Sie Ihre Marke maschinenlesbar machen
Vom PDF zum KI-Markengehirn in vier Schichten.
Sie wollen wissen, wo Ihr Unternehmen steht?
Vereinbaren Sie ein kostenloses Erstgespräch – unverbindlich und auf Augenhöhe.